引言
人工智能应用软件与传统的业务系统有着本质区别:它不仅需要处理确定性的业务逻辑,还必须承载不确定性的模型推理过程。这种双重属性使得架构设计成为项目成败的关键变量——一个糟糕的架构可能让效果优秀的模型在生产环境中沦为不可用的原型。本文从工程化视角出发,梳理人工智能应用软件系统架构设计的核心层次、关键决策和落地要点。
一、整体架构分层
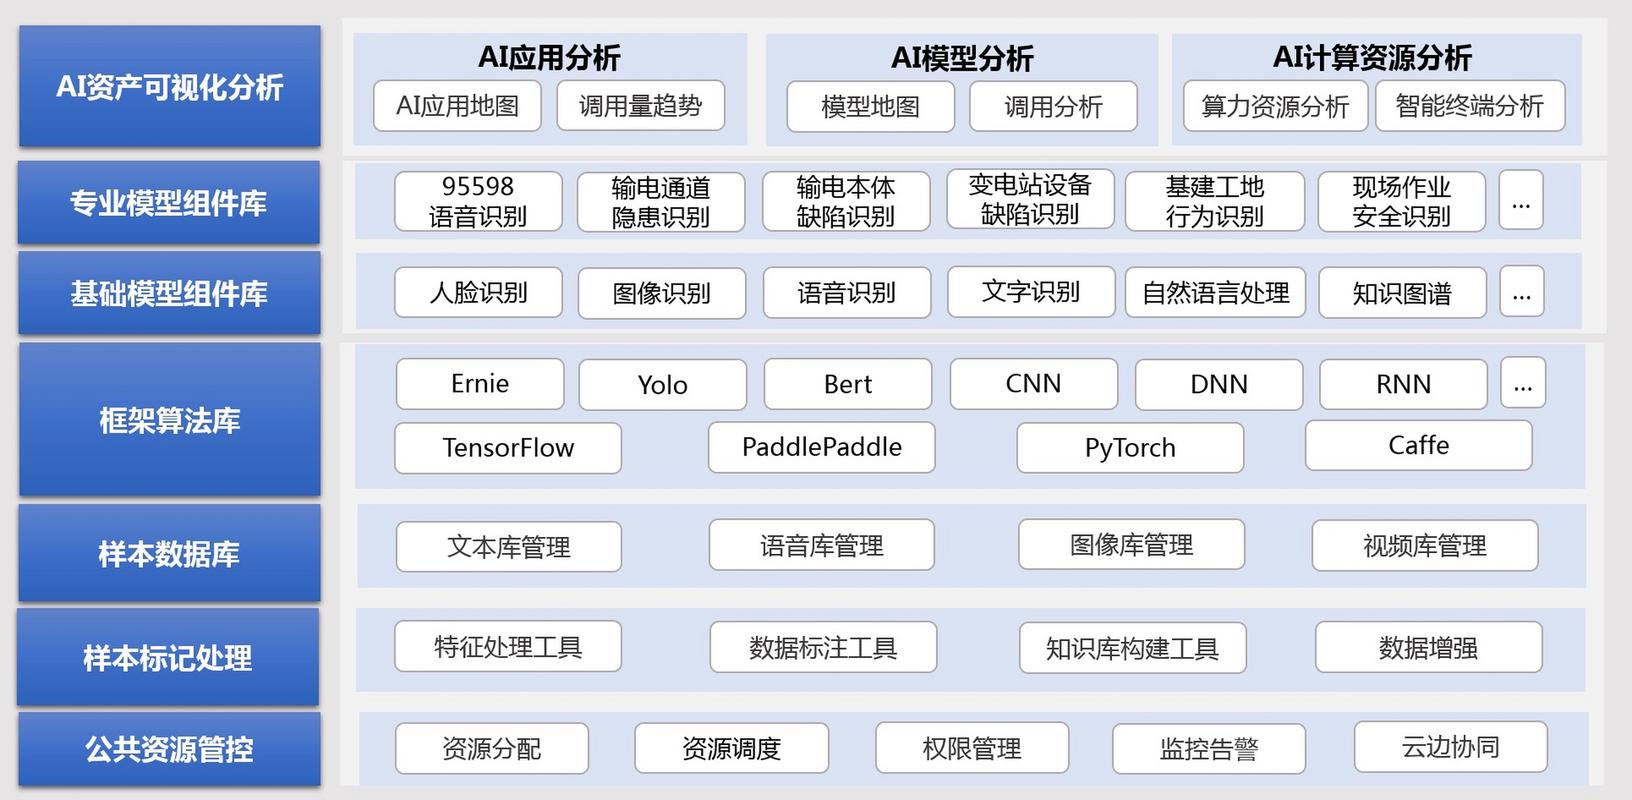
人工智能应用软件通常可以划分为五个协作层:
数据层承担数据采集、清洗、标注与版本管理。与常规系统不同,AI应用对数据版本的敏感度极高,训练数据的一次无记录变更可能导致模型行为不可复现,因此数据版本管理组件(如 DVC 或自建数据湖版本机制)应作为一等公民纳入架构。
模型层涵盖训练流水线、实验管理、模型注册与打包。MLflow、Kubeflow、Weights & Biases 等工具已经形成了较成熟的技术生态,架构师需要在这一层做出“平台化”还是“内生自建”的选择。
服务层将模型封装为可调用的在线服务,涉及推理 API、批处理作业、模型路由等能力。当前主流趋势是用统一推理网关屏蔽不同模型框架(PyTorch、ONNX、TensorRT 等)的差异。
应用层包括业务逻辑编排、API 聚合和面向用户的界面,它是模型能力与业务价值之间的转换器。
基础设施层提供容器编排、GPU 资源调度(Kubernetes + GPU Operator 已成事实标准)、监控告警和配置管理。
二、核心架构决策
在线推理 vs. 离线批处理。 如果模型输出覆盖时间窗要求以分钟或秒计,必须走在线推理链路;如果结果按天计算,批处理能合并上下文获得更高吞吐,并通过一致的入参预取得更高质量的最终结果。更多系统的实际做法混合管道——离线口径生成大波段基础得分,在线模型只负责精读增量。区分线上和离线并且把重活压在并行的路径中是比融汇两种路径在一个个请求上的更容易驾驭的选择。通常对于一次需求变更或时段敏感性高的任务单独构筑模型在线支持的做法仍是可靠的合理基卡数量规划办法(无法用太多?原文含糊;要更正表述重新组织这两段可能更好,见下方是否重写 —— rewrite)。改解。架构允许时可选两种做法或拆分两套由一致性清单(parity slab/orc)交叉口径核对的机制(reused),新模型第一个突破应采用简单却系统在线架构先确保可观测和速率应对受控后逐步降峰。若脱离清单的批量化可先流下来回沟子标注)。基于预精与精相比和滞后容忍时间的细分对最终可用性与审计透明有帮助。]
... (中间略) ...